그래프RAG는 정말 지고 있을까
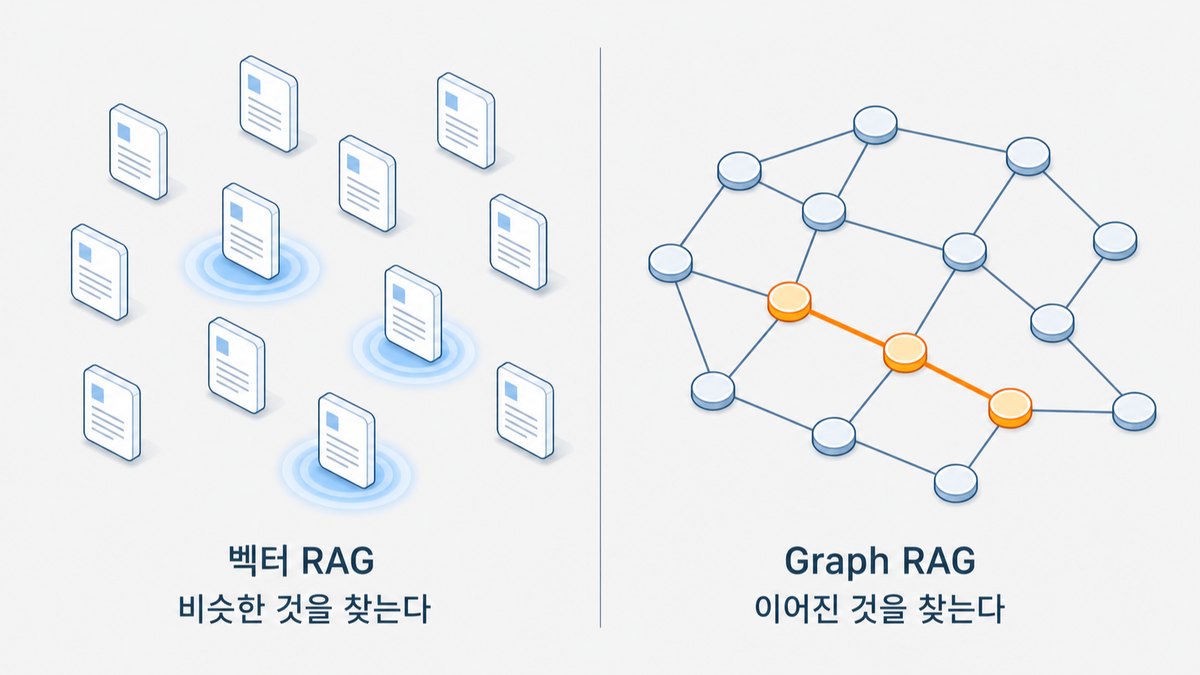
문서를 그래프로 엮어 AI에게 읽히는 방식이 몇 해 동안 당연한 다음 단계처럼 이야기됐습니다. 그런데 실증 연구가 쌓이면서 이런 보고가 이어졌습니다. 여러 실증 연구가, GraphRAG가 많은 과제에서 일반 RAG를 넘지 못한다고 보고했다.
이 태그가 붙은 글 · 모두 5편
문서를 그래프로 엮어 AI에게 읽히는 방식이 몇 해 동안 당연한 다음 단계처럼 이야기됐습니다. 그런데 실증 연구가 쌓이면서 이런 보고가 이어졌습니다. 여러 실증 연구가, GraphRAG가 많은 과제에서 일반 RAG를 넘지 못한다고 보고했다.
RAG를 붙였는데 답이 신통치 않을 때 나오는 흔한 처방이 "그래프로 바꿔보자"입니다. 그런데 그래프로 옮기고도 그대로인 경우가 적지 않습니다. 검색 방식이 문제가 아니었기 때문입니다.
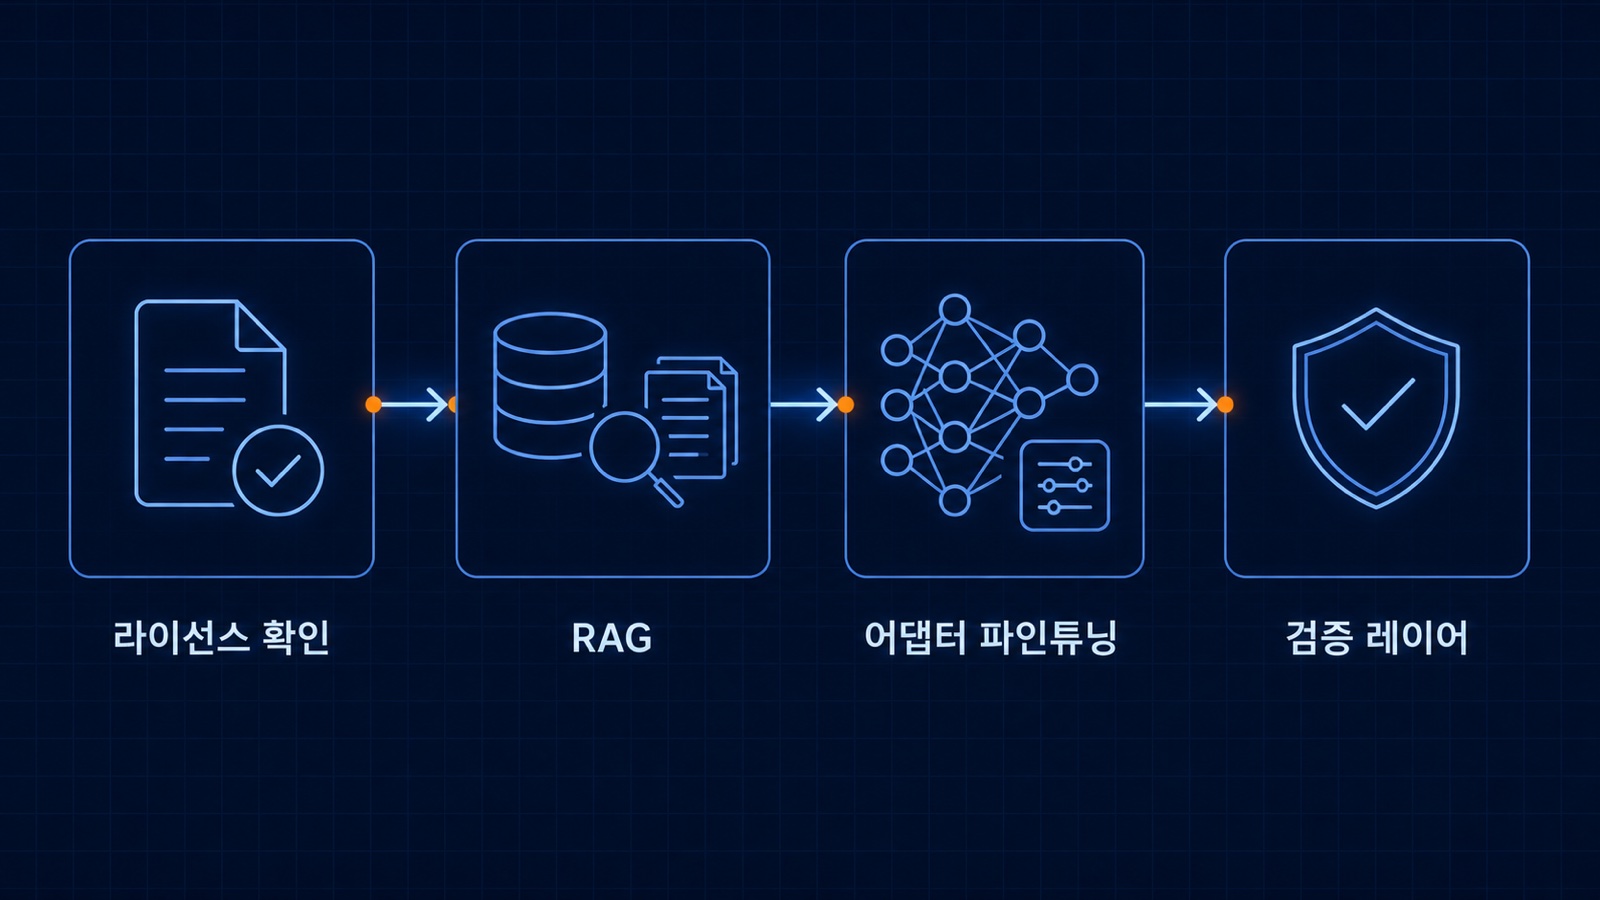
공장 데이터는 밖으로 못 나갑니다. 공정 조건, 수율, 설비 파라미터는 그 자체가 영업기밀이라, 제조기업이 AI를 검토할 때 가장 먼저 부딪히는 요구가 "우리 서버 안에서 돌아야 한다"입니다. 이 요구가 오픈소스(정확히는 오픈웨이트) LLM 채택의 1차 동력입니다.
생성형 AI가 화제가 되면서, 한 번쯤 이런 실험을 해보셨을 겁니다. 공장 데이터를 AI에 넣고 "이 불량의 원인이 뭐냐"고 물어보는 것. 그럴듯한 답이 나옵니다. 문장은 매끄럽고 자신감도 넘칩니다. 그런데 막상 현장 담당자가 보면 고개를 갸웃합니다. "이 설비는 그 공정에 안 쓰이는데?"
현장에 데모를 들고 가면 거의 매번 똑같은 장면이 나옵니다. 공장장님이 팔짱을 끼고 한참 보다가 이렇게 말씀하세요. "답은 잘 하네. 근데 이거 믿고 일해도 돼요?"