문서를 고친 뒤 새로 생긴 결함을 찾는 법저희 개정 78건에서 5건이 나왔습니다
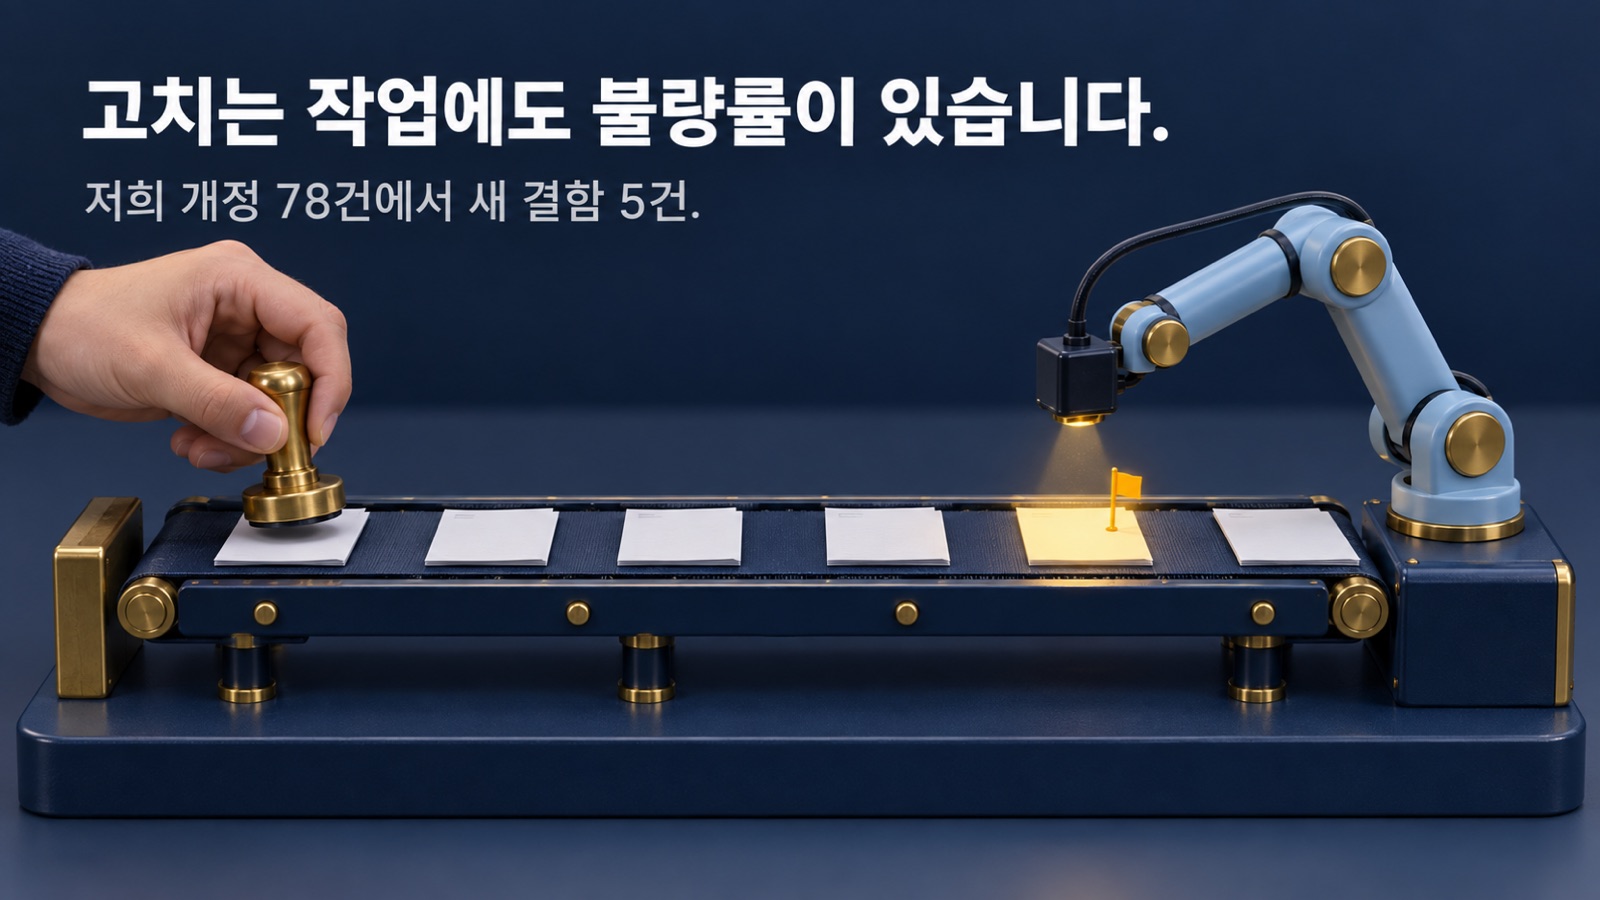
공정에는 불량률이 있고, 누구나 그 숫자를 관리합니다. 그런데 고치는 작업의 불량률은 잘 따지지 않습니다. 결함을 찾는 일에는 검사와 판정과 기록이 붙는데, 찾아낸 것을 반영하는 일은 "처리 완료" 한 줄로 넘어갑니다. 지적 78건을 반영했으면 78건이 없어진 것으로 칩니다.
이 태그가 붙은 글 · 모두 19편
공정에는 불량률이 있고, 누구나 그 숫자를 관리합니다. 그런데 고치는 작업의 불량률은 잘 따지지 않습니다. 결함을 찾는 일에는 검사와 판정과 기록이 붙는데, 찾아낸 것을 반영하는 일은 "처리 완료" 한 줄로 넘어갑니다. 지적 78건을 반영했으면 78건이 없어진 것으로 칩니다.
10 ms 스캔 6,000번, 상자 60개, 안전 사건 0건. 제조 AI 운영체제 VEXPLOR를 만드는 웨이스가 PLC 래더와 3D 설비 모형을 같은 스캔으로 맞물려 움직이는 가상 공장에서 포장 셀을 60초 동안 한 번 실행한 결과입니다.
업무에 AI를 붙이는 회사가 처음 부딪히는 질문은 「무엇을 자동화할까」입니다. 메일 초안, 보고서 요약, 견적 계산처럼 후보는 금방 나옵니다. 그런데 몇 주 쓰다 보면 질문이 바뀝니다. AI가 만든 결과를 어디까지 사람이 확인해야 하는가, 그리고 사람이 없는 밤에 실행된 작업이 제대로 끝났는지 어떻게 아는가입니다.
제조 AI 운영체제 VEXPLOR를 만드는 웨이스가 2026년 9월 21일 첫 기술보고서 TR-2026-01을 공개했습니다. 제목은 「Behavioral Equivalence Cannot See Dormant Logic」, 우리말로 옮기면 「동작 일치 검사는 잠자는 로직을 보지…
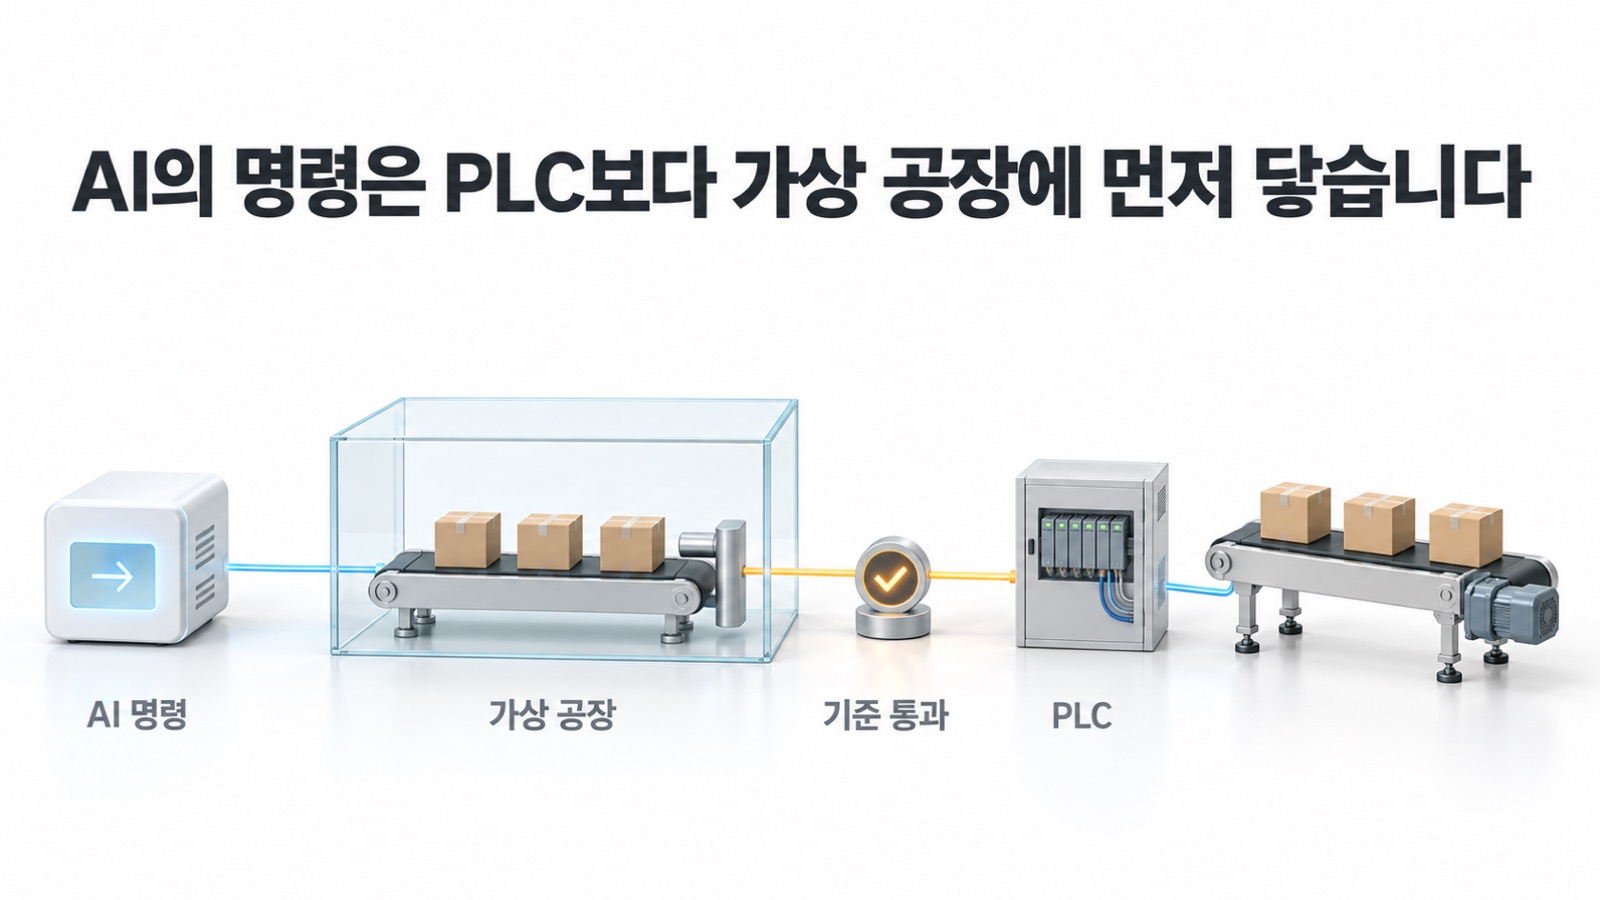
AI나 MES가 PLC에 직접 명령을 쓰는 공장에서는, 틀린 명령이 설비에 닿기 전에 한 번 막아 주는 장치가 필요합니다. 그 장치는 그 공장 PLC 프로그램을 그대로 옮겨 둔 검증용 프로그램에서 명령을 먼저 실행해 보고, 지켜야 할 조건이 깨지면 명령을 보내지 않습니다.
스타트업 팀을 판단하는 자리는 대개 짧습니다. 투자 미팅은 한 시간이고, 고객사 첫 방문은 30분입니다. 그 시간에 팀의 실력을 판단할 근거는 사실상 이력서 한 장이고, 이력서에서 가장 먼저 눈에 들어오는 것은 대학 이름입니다. 제조 AI 운영체제 VEXPLOR를 만드는 웨이스가 고객 공장에서 겪는 것도 같습니다.
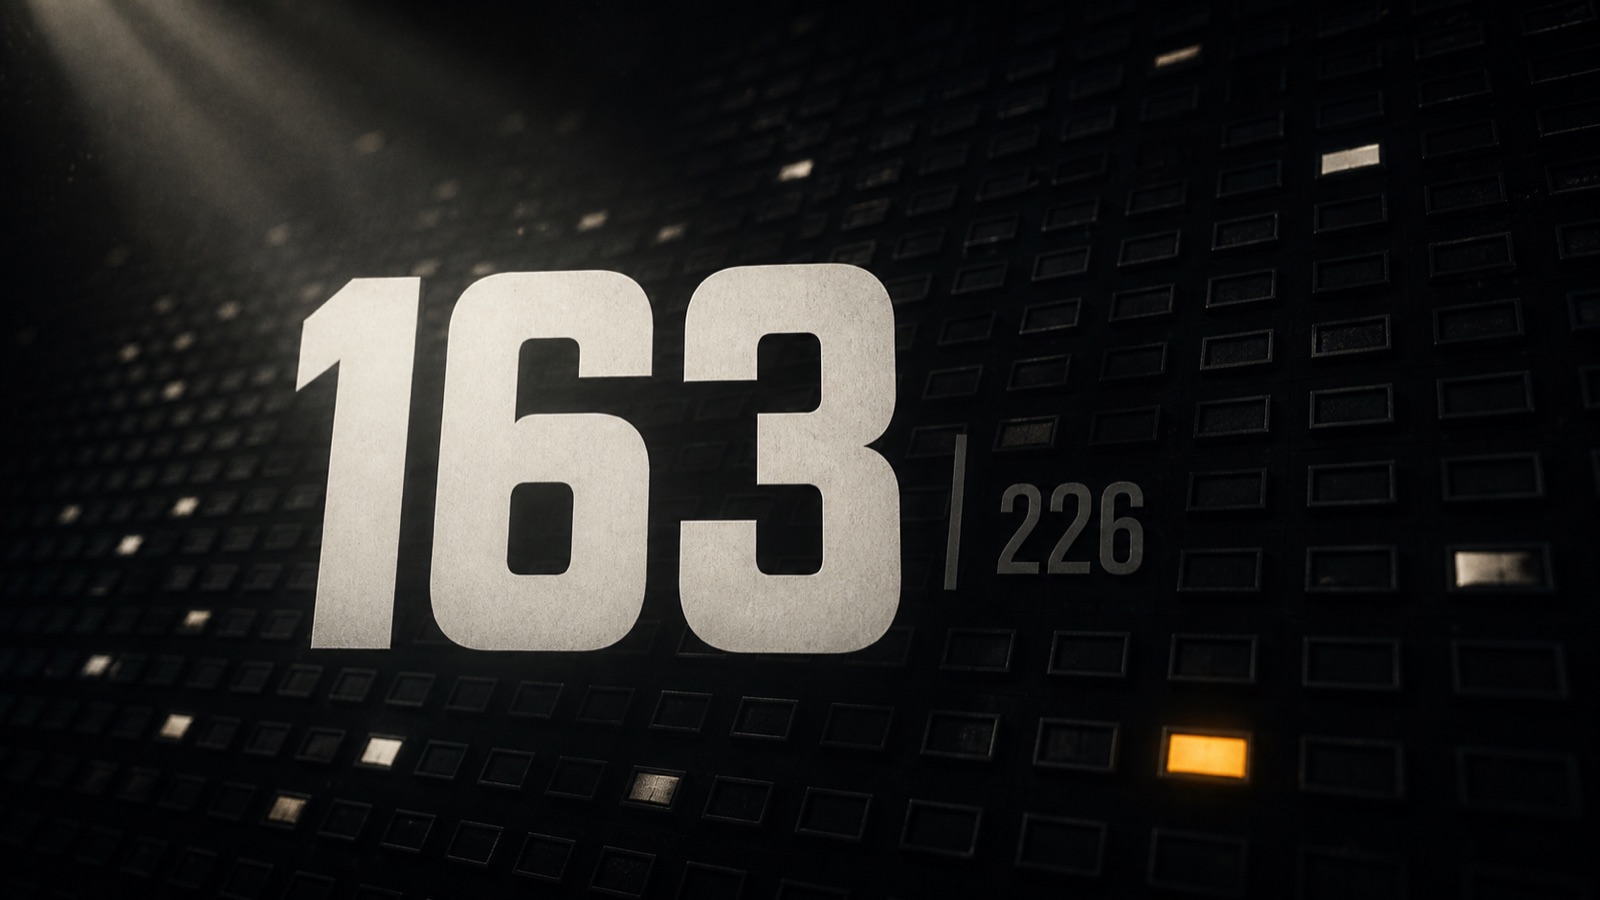
저희 기술블로그의 태그를 전부 세어 봤습니다. 글 106편에 태그가 226개였고, 그중 163개(72%)가 글 한 편에만 붙어 있었습니다. 태그 하나에 글 한 편. 독자가 그 태그를 누르면 글 한 편이 나옵니다. 방금 읽고 있던 그 글입니다.
검사를 돌렸는데 결과가 0건으로 나왔습니다. 이때 우리는 보통 안심합니다. 걸린 게 없다는 뜻이니까요. 그런데 0은 두 가지를 동시에 뜻합니다. 정말 없거나, 검사가 고장 났거나. 이 둘은 화면에서 똑같이 생겼습니다. 오류 메시지도, 빨간 글자도, 종료 코드 1도 없습니다. 그냥 조용히 0입니다.
진단을 마치면 저희는 고객에게 "이 공정은 몇 단계입니다"라고 말씀드립니다. 그 말을 듣는 쪽에서 물어야 할 것이 하나 있습니다. 그 숫자는 무엇을 보고 매긴 것인가.
AI에게 일을 맡기기 시작하면 검사 장치가 따라 늘어납니다. 사람이 결과물을 일일이 다 볼 수 없으니 자동으로 훑는 스크립트를 만들어 붙이고, 그 스크립트가 통과를 내면 다음 단계로 넘깁니다. 코드 린터, 테스트, 배포 전 점검, 문서 검사 — 형태는 달라도 하는 일은 같습니다. 사람 대신 봐 주는 것입니다.
데이터를 보고 결정하는 일에는 잘 안 보이는 단계가 하나 있습니다. 그 데이터가 원본인지, 원본을 요약한 사본인지는 화면에 적혀 있지 않습니다. 두 화면은 대개 똑같이 생겼습니다. 같은 항목이 같은 자리에 있고 숫자만 다릅니다.
밖으로 신호를 보내는 일에는 공통된 약점이 하나 있습니다. 그 신호가 상대에게 어떻게 읽혔는지는 우리 쪽에 안 남는다는 것입니다. 메일을 보내면 보낸편지함에는 남지만 상대가 스팸으로 걸렀는지는 모릅니다. API를 호출하면 200이 돌아오지만 상대 시스템이 그 값을 버렸는지는 모릅니다.
같은 도구를 사용합니다. 같은 모델이고 요금제도 같습니다. 하루에 들이는 시간도 비슷합니다. 그런데 몇 달 지나면 나오는 양이 몇 배 차이 납니다. 프롬프트를 잘 쓰는 요령의 문제가 아닙니다. 도구에 무엇을 시키고 있는지가 다릅니다.
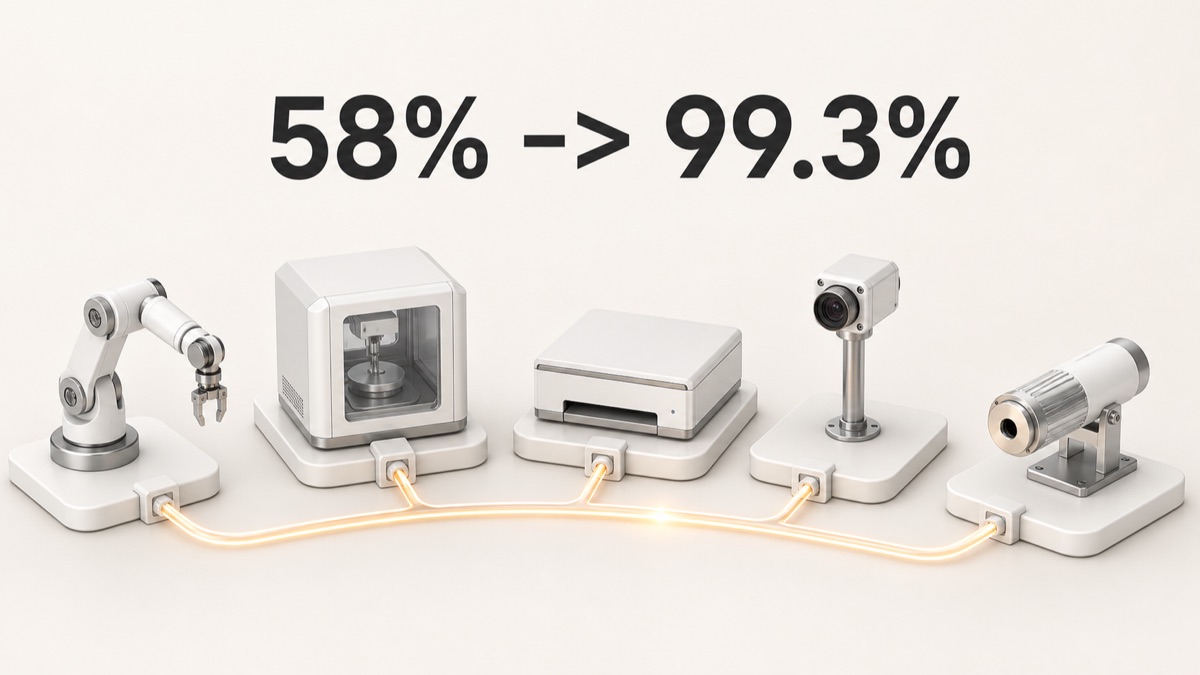
양자컴퓨터의 레이저 주파수 잠금이 풀리면 다시 잡아야 합니다. 벤더 스크립트의 복구 성공률은 58%, 한 번에 150초가 걸렸습니다. AI 에이전트가 밤새 그 절차를 스스로 고쳐 쓴 결과, 아침에는 6초에 96%가 됐습니다. 그렇게 완성된 스크립트를 같은 교란 세트로 다시 돌리자 700회 중 695회, 99.3%였습니다.
설비 수십 대가 맞물려 돌아가는 생산 라인을 3D로 재현하는 시뮬레이터를, 밤새 사람 없이 15라운드 돌렸습니다. 빌드 → 검증 → 수정 → 릴리스를 한 묶음으로 두고 그 묶음을 반복하게 한 것입니다. 아침에 결과를 열어 봤습니다.
저희는 공장의 현황을 항목별로 매기는 진단 도구를 만듭니다. 값은 담당자에게 묻는 대신 회의 기록과 기존 자료로 자동으로 채워집니다.
저희는 공장에서 쓰는 소프트웨어와 현황 진단 도구를 만듭니다. 이 도구는 한 공장의 데이터·설비·공정 관리 수준을 항목별로 매기는데, 그 값을 담당자에게 일일이 묻지 않고 회의 기록과 기존 자료로 자동으로 채웁니다.
팀이 사용하는 도구에 규칙을 하나 넣었다고 해 봅시다. 위험한 명령을 실행하기 전에 한 번 물어보는 확인, 파일을 고치기 전에 사본을 떠 두는 백업, 작업을 끝낼 때 빠뜨린 것이 없는지 훑는 점검 같은 것들입니다. 코드를 쓰고, 테스트를 돌리고, 초록불을 확인하고, 팀에 공지합니다.
전에 저희는 이 블로그에 합의는 검증이 아니다라고 썼습니다. 같은 모델을 쓰는 에이전트 스무 개는 같은 오류에 만장일치로 동의하므로, 검증은 언제나 시스템 밖의 증거가 한다는 이야기였습니다.